AI 이해하기 3편 · 모아의 기웃기웃
1편 · AI는 어떻게 배울까? → 2편 · 학습률·모멘텀·Adam → 3편 · 신경망
앞에서는 점에 맞춰 선을 움직이고, 손실을 줄이는 속도를 비교했습니다. 그런데 선을 아무리 잘 움직여도 정답을 표현할 수 없다면 어떨까요?
이번에는 네 개의 점으로 출발합니다. 작은 문제지만, 신경망에 왜 은닉층과 활성화 함수가 들어가는지 직접 확인하기에 좋습니다. 먼저 그림으로 보고, 중간에서 계산을 따라간 뒤, 마지막에는 가중치 17개가 실제로 학습되는 과정을 살펴보겠습니다.
실험은 설치 없이 열립니다. 네이버 본문에서는 링크를 눌러 새 페이지에서 조작하는 방식입니다.
1. 서로 다르면 1: 직선 하나가 막히는 작은 문제
두 스위치가 있다고 생각해 보세요. 두 스위치의 상태가 서로 다를 때만 불이 켜지고, 같으면 꺼집니다. 이 규칙을 XOR, 우리말로 배타적 논리합이라고 합니다.
| 입력 x₁ | 입력 x₂ | 정답 |
|---|---|---|
| 0 | 0 | 0 |
| 0 | 1 | 1 |
| 1 | 0 | 1 |
| 1 | 1 | 0 |
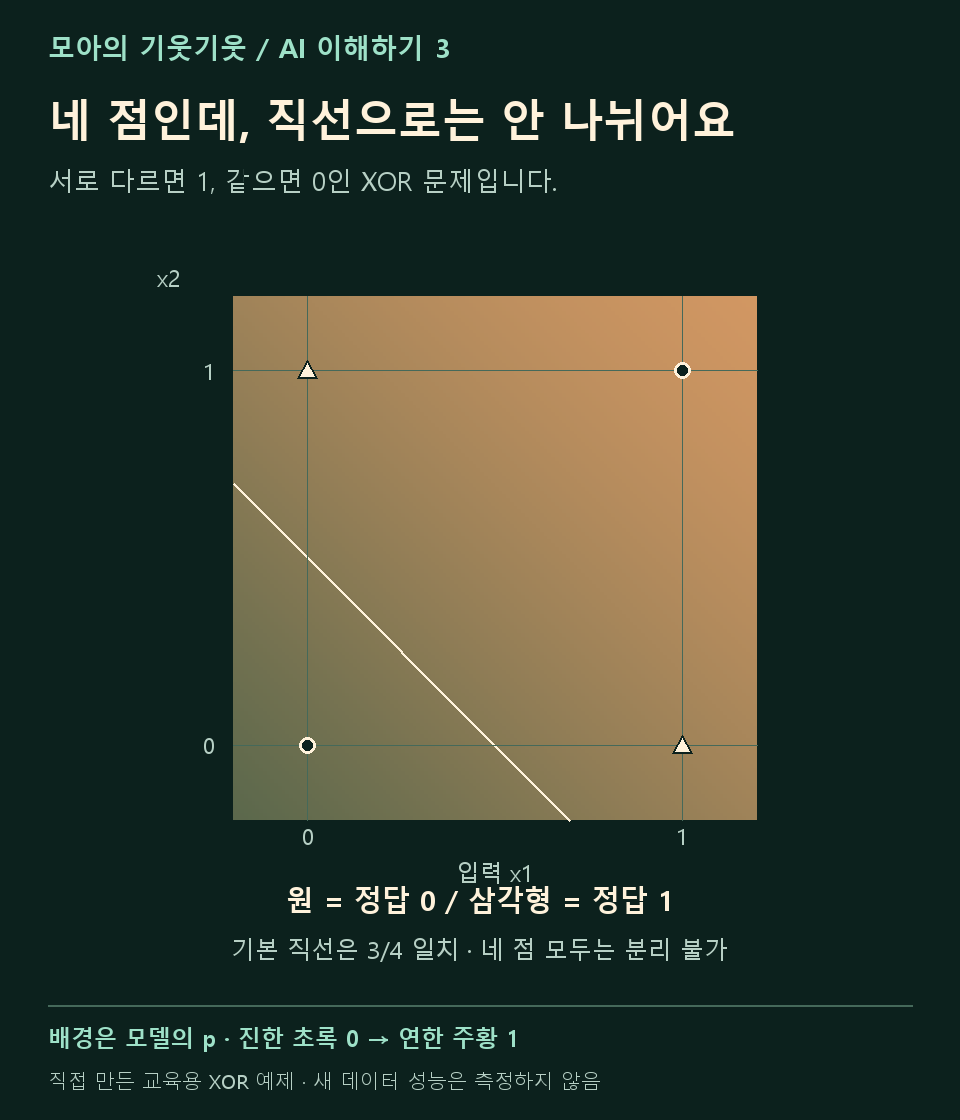
가로축과 세로축에 두 입력을 놓으면, 같은 정답끼리 서로 대각선에 있습니다. 직선을 어디로 옮기거나 돌려도 두 무리를 완벽하게 분리할 수 없습니다. 한 무리를 잇는 대각선과 다른 무리를 잇는 대각선이 한가운데서 교차하기 때문입니다.
여기서 필요한 것은 더 오래 학습하는 일만이 아닙니다. 정답을 표현할 수 있는 모델이어야 합니다. Google의 신경망 입문 자료도 직선으로 나눌 수 없는 분류 문제에서 신경망의 필요성을 설명합니다. 개념 출처: Google 신경망 입문
2. 뉴런 하나는 무슨 계산을 할까?
뉴런은 입력마다 가중치를 곱해 더하고, 편향을 더한 뒤, 활성화 함수를 통과시킵니다. 가중치는 각 입력을 얼마나 반영할지, 편향은 판단의 기준을 어디로 옮길지 조절하는 숫자입니다.
입력이 두 개인 이진 분류 예제라면 z=w₁x₁+w₂x₂+b, p=sigmoid(z)로 쓸 수 있습니다. 시그모이드는 z를 0과 1 사이 값으로 바꿉니다. 여기서는 p≥0.5면 1로 분류합니다. p는 모델의 예측값이며, 현실에서 그 비율만큼 반드시 맞는다는 보장은 아닙니다.
판단이 바뀌는 곳은 z=0, 즉 w₁x₁+w₂x₂+b=0입니다. 입력이 두 개이므로 이 경계는 직선입니다. 출력에 시그모이드를 붙였다고 분류 경계까지 저절로 구부러지지는 않습니다.
실험의 기본 직선은 w₁=1, w₂=1, b=−0.5입니다. 이 선은 네 점 중 세 점, 즉 75%를 맞힙니다. 하지만 네 점을 모두 맞힐 수는 없습니다. “XOR에서 직선의 최대 정확도가 50%”라고 설명하면 부정확한 이유입니다.
반면 네 점을 똑같이 반영하는 로지스틱 회귀의 교차엔트로피 손실은 p=0.5일 때 최소가 됩니다. 이때 손실은 ln2≈0.6931입니다. 최대 일치율을 찾는 문제와 평균 손실을 최소화하는 문제는 구분해야 합니다. 이 수치는 아래 XOR 정의와 손실식을 직접 계산한 값입니다.
3. 은닉층은 입력을 다른 관점으로 다시 표현한다
입력과 최종 출력 사이의 계산 층을 은닉층이라고 합니다. 정답을 숨겨놓았다는 뜻이 아니라, 중간 계산값에 별도의 정답을 직접 붙여주지 않는다는 뜻입니다.
이번에는 두 개의 중간 유닛을 넣어 보겠습니다. 하나는 x₁이 x₂보다 큰 부분을, 다른 하나는 x₂가 x₁보다 큰 부분을 골라냅니다. 출력 층은 이 두 결과를 조합합니다. 실제 학습에서는 이런 중간 표현을 사람이 하나씩 정해주는 대신, 손실이 줄어들도록 가중치를 함께 조정합니다. 구조 출처: Google 뉴런과 은닉층
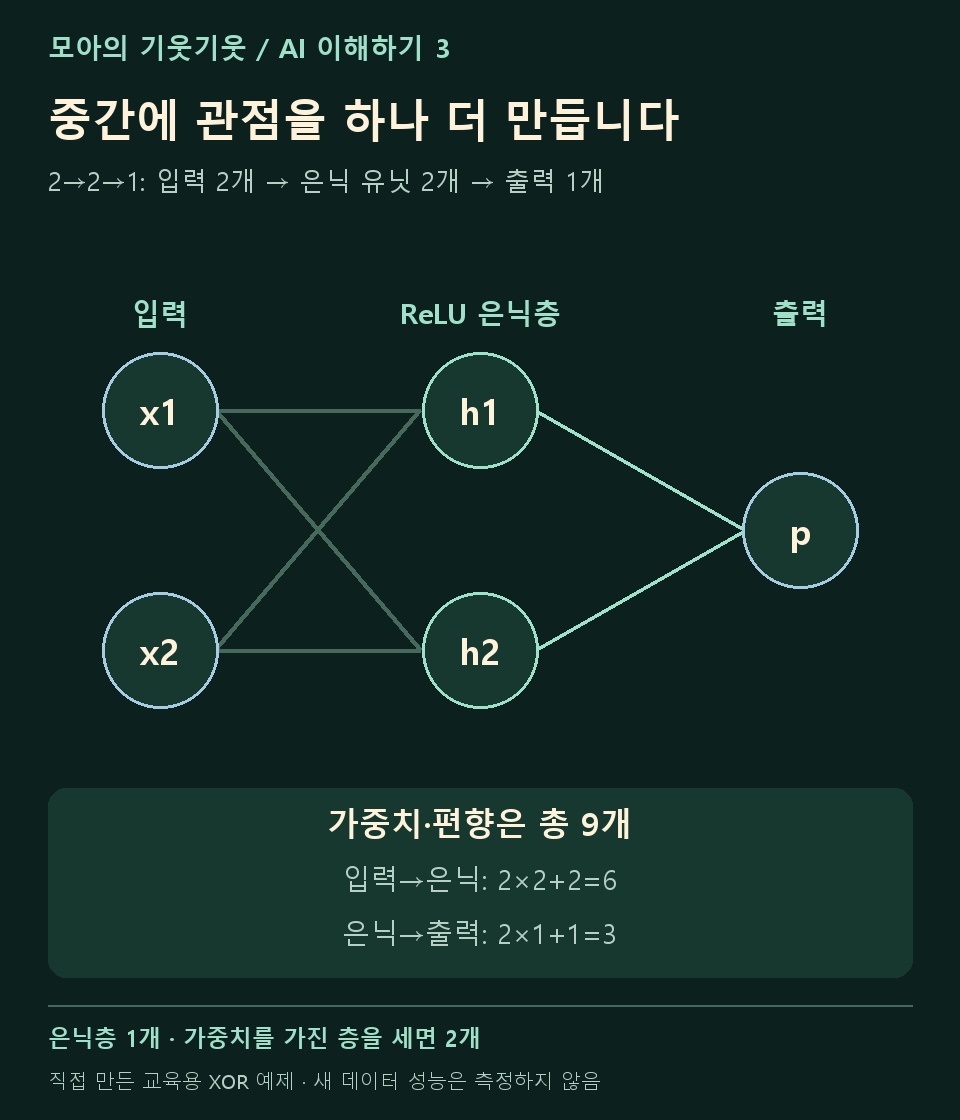
표기 2→2→1은 입력 2개, 은닉 유닛 2개, 출력 1개를 뜻합니다. 은닉층은 한 개이고, 가중치를 가진 층을 세면 은닉층과 출력층 두 개입니다. 입력층까지 세는 설명도 있으므로 “몇 층”인지는 기준을 함께 봐야 합니다.
이 작은 예제의 가중치·편향은 총 9개입니다. 입력→은닉에서 2×2+2=6개, 은닉→출력에서 2×1+1=3개입니다. 가운데 유닛을 늘리는 것은 폭을 넓히는 일이고, 중간 층을 더 넣는 것은 깊이를 늘리는 일입니다.
4. 층만 늘려서는 부족하다: 활성화 함수
중간 층에서 곱셈과 덧셈만 반복하면, 최종 결과도 하나의 곱셈과 덧셈으로 정리됩니다. 예를 들어 2(3x+1)+4=6x+6입니다. 행렬을 쓰는 여러 입력에서도 같은 원리가 성립합니다.
활성화 함수는 이 사이에 비선형 변환을 넣습니다. ReLU는 음수는 0으로 만들고 양수는 그대로 통과시킵니다. tanh는 입력을 −1과 1 사이로 부드럽게 압축합니다. 두 함수 모두 단순한 직선 하나와는 다른 모양입니다. 원리·함수 정의: Google 활성화 함수
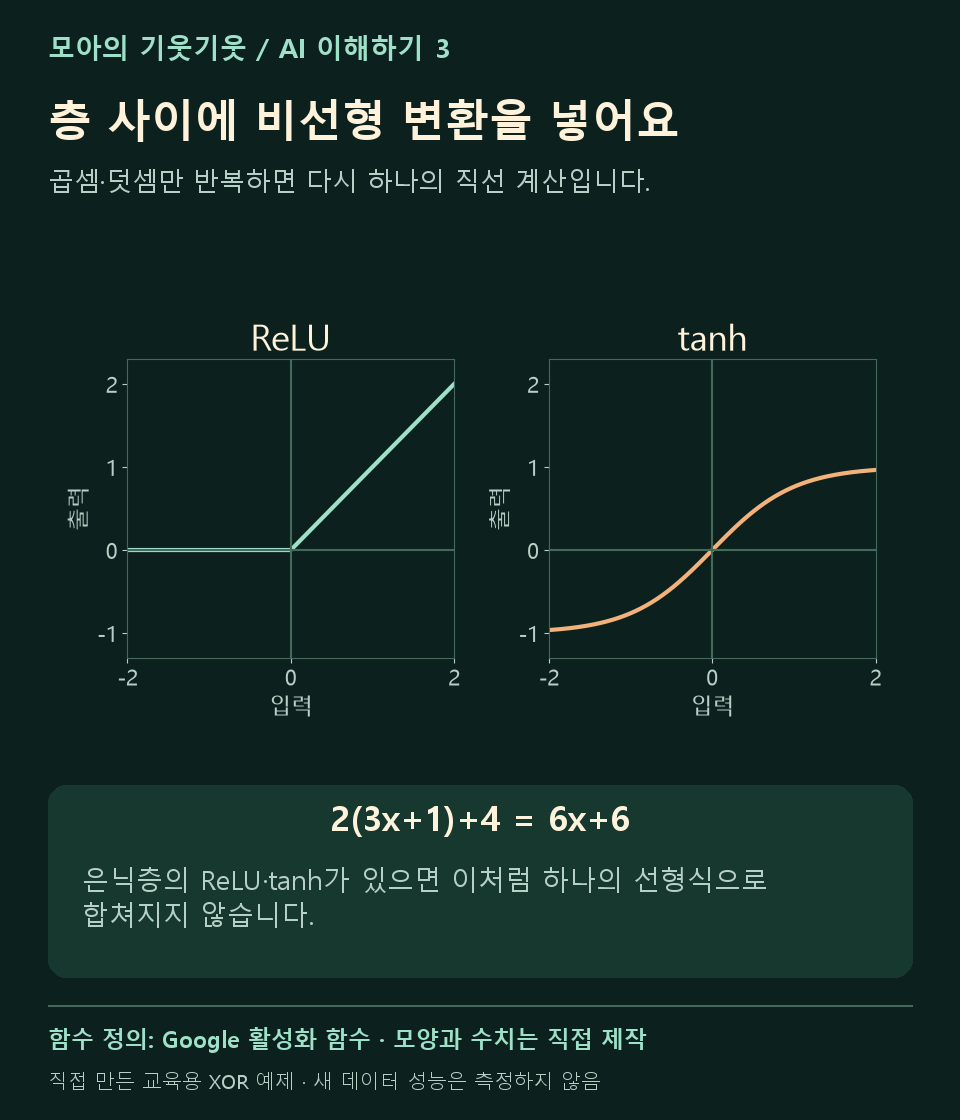
여기서는 설명이 쉬운 ReLU로 계산을 먼저 보고, 뒤의 실제 학습 실험에서는 tanh를 사용합니다. 두 예제는 구조와 가중치가 다르며, 함수의 성능 우열을 비교하는 실험은 아닙니다.
5. 숫자로 확인하기: 손으로 설계한 XOR 신경망
원리를 보이기 위해 이번 단락의 가중치는 사람이 직접 정했습니다. 학습으로 얻었다고 소개하는 결과가 아닙니다.
• h₁=ReLU(x₁−x₂)
• h₂=ReLU(x₂−x₁)
• z=8h₁+8h₂−4, p=sigmoid(z)
x₁=1, x₂=0이면 h₁=1, h₂=0입니다. 따라서 z=4이고 p≈0.9820이므로 1로 분류합니다. 두 입력이 같으면 h₁=h₂=0, z=−4, p≈0.0180이므로 0입니다. 네 모서리에서는 정답을 모두 맞힙니다.
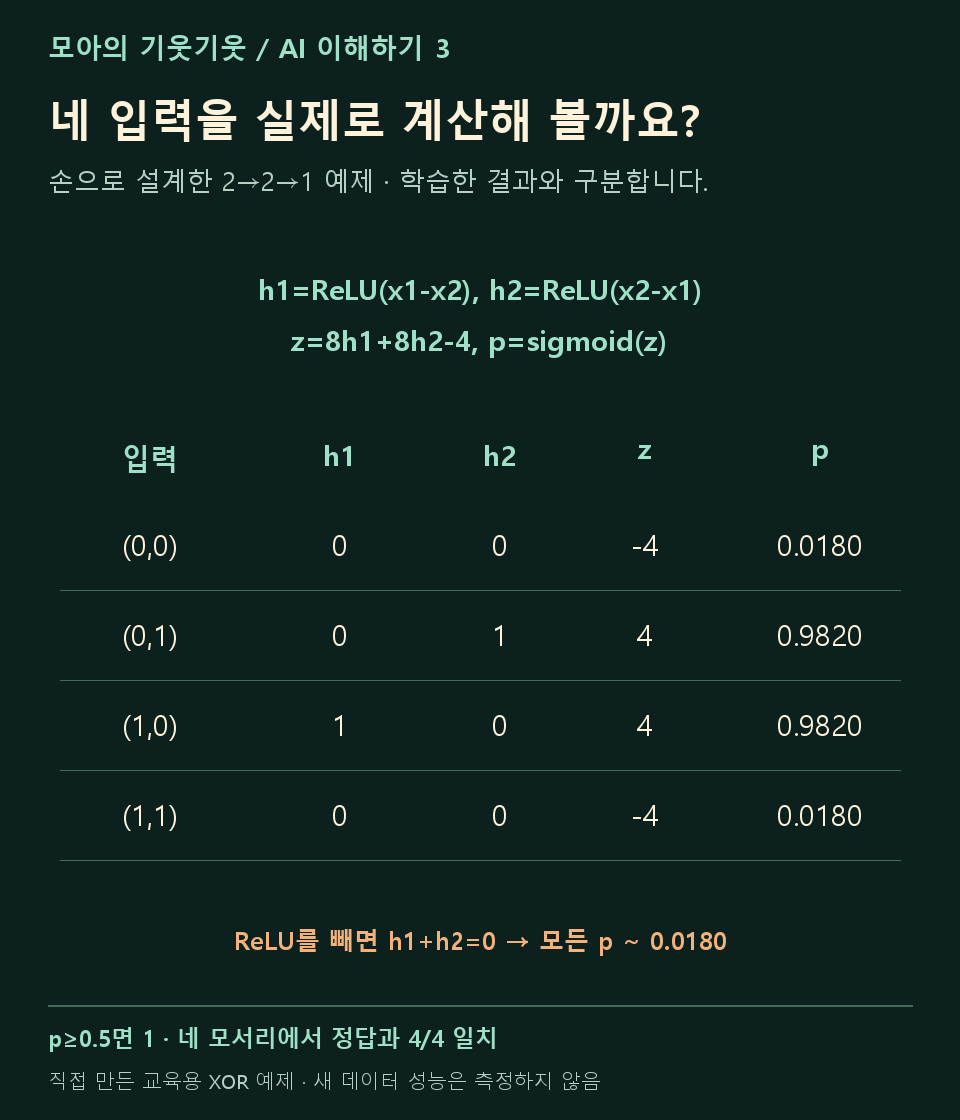
8과 −4가 중요한 이유도 있습니다. 이 설정에서는 z=8|x₁−x₂|−4라서 경계가 |x₁−x₂|=0.5가 됩니다. 8은 시그모이드의 변화가 얼마나 가파른지에, −4와의 비율은 경계 위치에 영향을 줍니다. 보편적인 AI 권장값이 아니라, 이 규칙을 눈에 보이게 만든 교육용 설정입니다.
인터랙티브 실험의 ‘2. 은닉층으로 조합’에서 ReLU를 꺼보세요. h₁+h₂=(x₁−x₂)+(x₂−x₁)=0으로 상쇄되어, 같은 가중치에서는 모든 입력의 p가 약 0.0180이 됩니다. 중간 활성화가 경계를 바꾸는 모습을 확인할 수 있습니다.
참고로 0과 1 사이 중간 좌표에는 이번 데이터가 정답을 제공하지 않습니다. 배경의 색은 모델이 그곳에서 어떤 예측을 내놓는지 보여주는 것이며, 그 색 전체가 검증된 정답 지도라는 뜻은 아닙니다.
6. 이번에는 답을 넣지 않고 실제로 학습시켜 보자
실제 학습 탭에서는 은닉 유닛을 4개 둔 2→4→1 신경망을 사용합니다. 가중치·편향은 2×4+4+4×1+1=17개입니다. 은닉층에는 tanh, 출력에는 시그모이드를 사용합니다.
과정은 이전 편과 이어집니다. 입력으로 예측을 계산하는 순전파 → 정답과 비교해 손실 계산 → 역전파로 각 가중치의 기울기 계산 → 경사하강법으로 가중치 갱신의 반복입니다. 역전파는 기울기를 구하는 계산이고, 경사하강법은 그 기울기로 숫자를 바꾸는 규칙입니다. 학습 원리 출처: Google 역전파
분류 손실은 평균 이진 교차엔트로피를 사용합니다. 정답이 1인데 p가 작거나, 정답이 0인데 p가 클수록 벌점이 커집니다. 식은 −평균[y ln p+(1−y)ln(1−p)]이며 자연로그를 씁니다. 계산에서는 로그에 0이 들어가지 않도록 z에서 안정적으로 계산한 동등한 식을 사용했습니다. 손실 정의·수치 안정성 출처: PyTorch BCEWithLogitsLoss
| 가중치 갱신 횟수 | 평균 손실 | 학습 네 점 중 일치 |
|---|---|---|
| 0회 | 0.9912 | 1/4 |
| 100회 | 0.5550 | 3/4 |
| 500회 | 0.0230 | 4/4 |
| 1,000회 | 0.0071 | 4/4 |
| 2,000회 | 0.0027 | 4/4 |
위 표는 이번에 직접 구현한 계산 결과입니다. 초기 시드 42, 학습률 0.30을 고정했고, 매번 네 점 전체의 평균 기울기로 갱신했습니다. 무작위 미니배치, 모멘텀, Adam, 가중치 감쇠는 사용하지 않았습니다. 이 학습률은 이 작은 실험의 설정이며 다른 모델에 그대로 적용할 기준은 아닙니다.
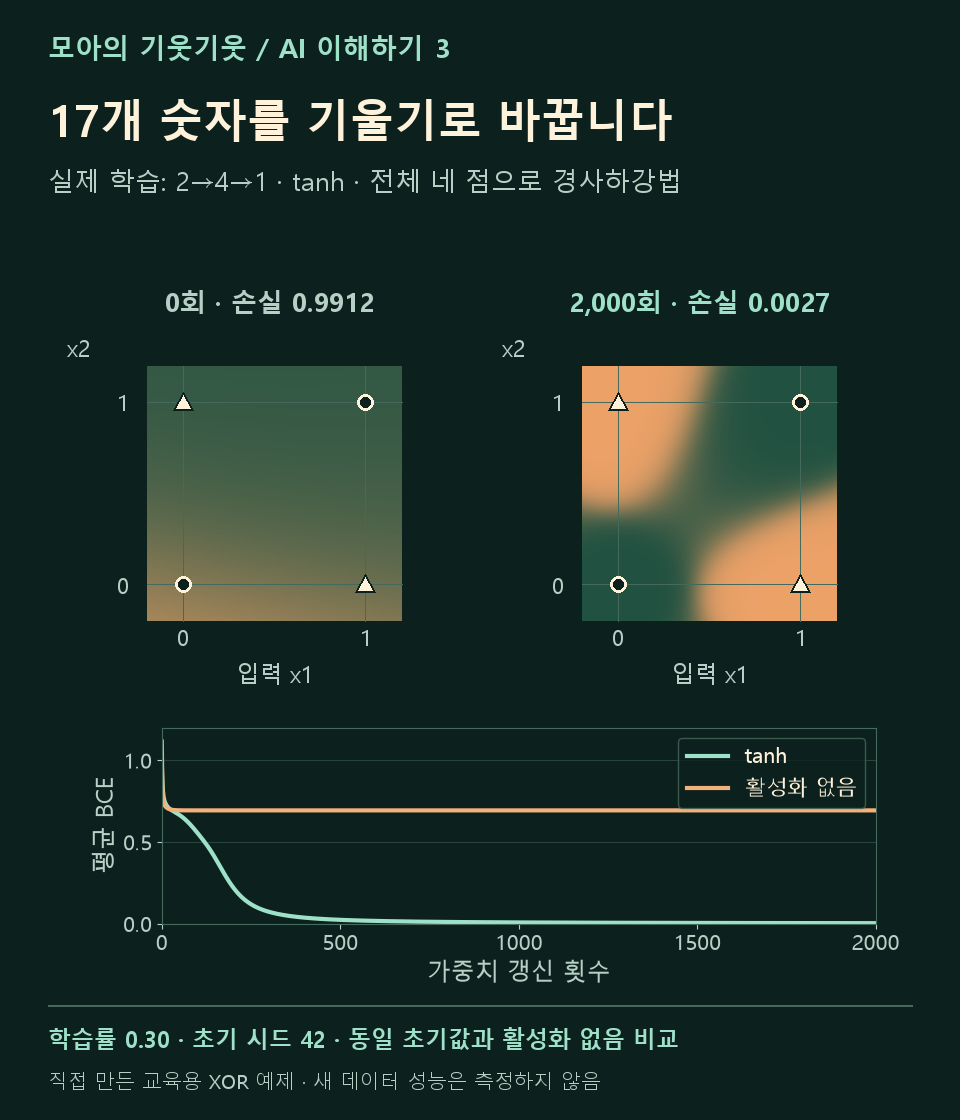
500회 이후에는 모두 4/4이지만 손실은 계속 줄어듭니다. 같은 정답을 내더라도 예측이 정답 쪽으로 더 가까워질 수 있기 때문입니다. 2,000회 후 네 입력 순서 (0,0), (0,1), (1,0), (1,1)의 p는 약 0.0011, 0.9970, 0.9971, 0.0038입니다.
동일한 초기 가중치와 학습률에서 은닉 활성화만 빼면, 2,000회 후 평균 손실은 약 0.6931입니다. 중간 유닛이 네 개여도 하나의 직선 경계로 합쳐지기 때문입니다. p≈0.5 주변의 분류 개수는 아주 작은 계산 오차에도 달라질 수 있으므로, 이 비교에서는 손실과 경계 형태를 함께 보세요.
7. 그러면 층을 많이 쌓을수록 좋을까?
층은 앞 층이 만든 표현을 다시 조합하게 합니다. 예를 들어 이미지에서는 주변 픽셀의 작은 무늬를 조합해 더 큰 형태를 표현하는 데 깊이가 도움이 될 수 있습니다. 다만 모든 신경망의 중간 유닛이 사람이 이름 붙일 수 있는 개념을 하나씩 담당하는 것은 아닙니다.
이번 XOR은 은닉층 한 개로 충분합니다. 신경망의 필요성을 보여주지만, 깊은 신경망이 반드시 필요하다는 예제는 아닙니다. 같은 문제를 x₁+x₂−2x₁x₂처럼 사람이 만든 비선형 특징으로도 표현할 수 있습니다. 신경망은 유일한 해결법이 아니라, 중간 표현을 학습하는 방법 중 하나입니다.
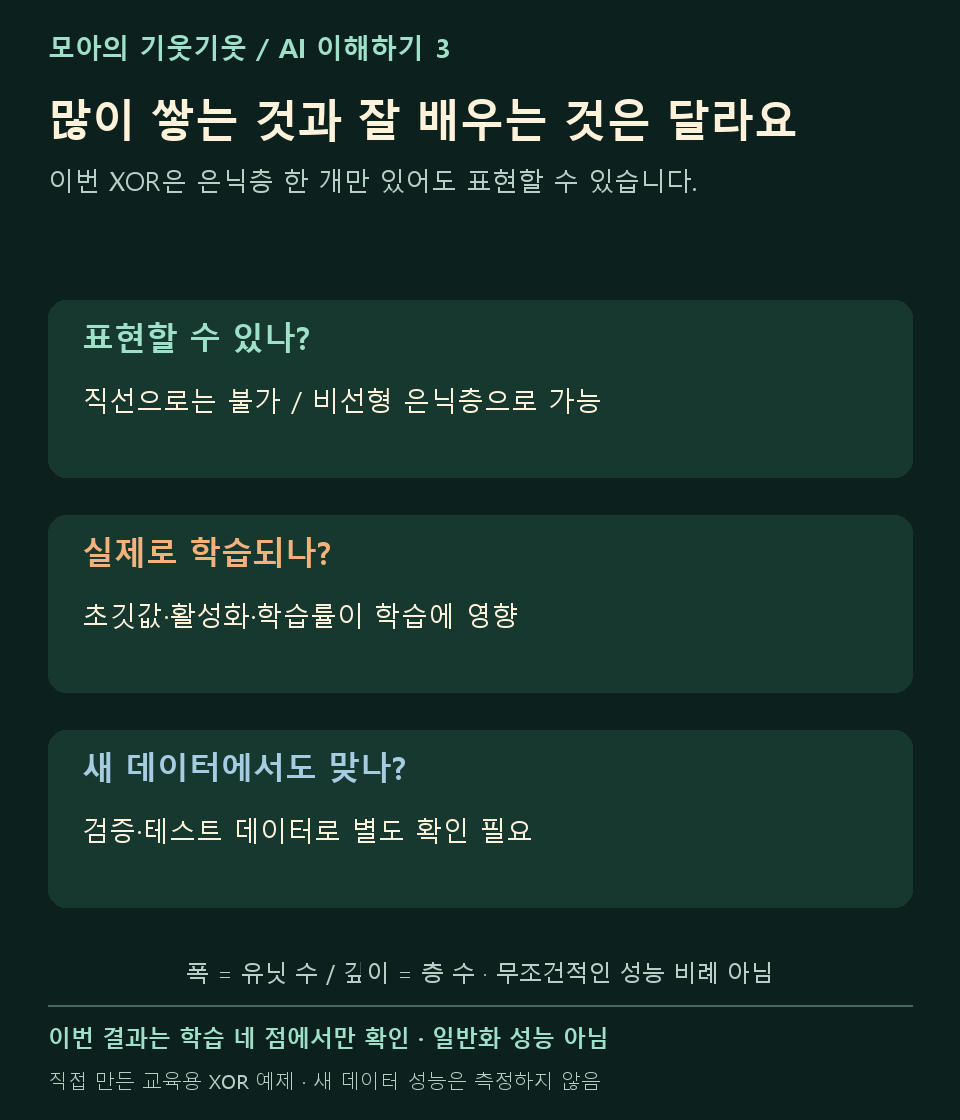
층이나 유닛을 늘리면 표현 선택지가 넓어지지만 계산량과 학습의 어려움도 달라집니다. 깊은 모델에서는 기울기 소실·폭주 등으로 학습이 어려워질 수도 있습니다. 따라서 “같은 매개변수 수면 깊은 쪽이 언제나 우수하다”거나 “크게 만들수록 성능이 비례한다”고 정할 수 없습니다. 학습상 한계 출처: Google 역전파와 학습 문제
무엇보다 이번 실험은 학습한 네 점만 확인했습니다. 별도의 검증·테스트 데이터가 없으므로, 4/4를 현실 문제에서의 정확도 100%라고 읽으면 안 됩니다. 표현할 수 있는지, 학습이 되는지, 새로운 데이터에서도 맞는지는 서로 다른 질문입니다.
8. 직접 해볼 순서
• ‘직선의 한계’에서 w₁·w₂·b를 바꿔 네 점을 나눠보세요. 세 점을 맞혀도 네 번째가 남는지 확인합니다.
• ‘은닉층으로 조합’에서 입력을 (1,0), (1,1)로 바꿔 중간 계산을 비교하세요. ReLU를 끄면 무엇이 상쇄되는지도 봅니다.
• ‘실제 학습’에서 0회 → 100회 → 500회 → 2,000회를 비교하세요. 활성화 없음으로 바꾼 뒤 같은 횟수에서도 결과가 달라지는지 확인합니다.
56초 · 한국어 자막 애니메이션 · 음성 없음
직접 제작한 한국어 자막 영상입니다. 음성 없이 볼 수 있으며, 본문의 손으로 설계한 예제와 실제 학습 결과를 구분해 보여줍니다.
다음에는 ‘학습한 데이터는 다 맞혔는데, 처음 보는 데이터에서도 맞을까?’를 살펴보면 자연스럽게 이어집니다. 과적합과 일반화 이야기입니다.
출처와 수치의 기준
자료 확인: 2026년 11월 21일. 위의 외부 링크는 신경망 구조·활성화·역전파·손실 정의의 근거입니다. XOR 가중치, 매개변수 개수, 확률, 손실, 학습 횟수별 결과는 본문에 밝힌 조건에서 직접 계산했습니다. 외부 논문이나 제품의 성능 수치가 아닙니다. 그림 6장과 영상도 같은 예제와 계산으로 직접 제작했습니다.
#신경망 #인공신경망 #딥러닝기초 #AI공부 #머신러닝 #은닉층 #활성화함수 #ReLU #XOR #역전파 #경사하강법 #모아의기웃기웃